Terkadang kita berhadapan dengan himpunan data yang memuat banyak titik data di dalam ruang berdimensi tinggi. Misalnya, dalam Kegiatan 6.5.4 kita menelaah himpunan data yang menggambarkan indeks lemak tubuh (BFI), dengan setiap titik data berdimensi enam. Pemahaman intuitif terhadap data tersebut sulit dibangun karena data itu tidak dapat divisualisasikan.
Bagian ini menelaah teknik yang disebut analisis komponen utama, yang memungkinkan kita mengurangi dimensi suatu himpunan data agar dapat divisualisasikan atau dipelajari sedemikian rupa sehingga ciri-ciri yang menarik lebih mudah terlihat. Pembahasan sebelumnya tentang varians dan diagonalisasi ortogonal matriks simetris menyediakan gagasan-gagasan utamanya.
Misalkan \(\uvec\) adalah vektor eigen satuan dari \(C\) dengan nilai eigen \(\lambda\text{.}\) Berapakah varians \(V_{\uvec}\) pada arah \(\uvec\text{?}\)
Pada arah manakah varians bernilai paling besar, dan berapakah varians pada arah tersebut? Jika data diproyeksikan ke garis ini, berapa banyak varians yang hilang?
Berikut beberapa gagasan terdahulu yang akan sangat berguna dalam bagian ini. Ingat bahwa matriks kovarians suatu himpunan data adalah \(C=\frac 1N AA^T\text{,}\) dengan \(A\) sebagai matriks yang kolom-kolomnya merupakan \(N\) titik data terpusat.
Jika \(\uvec\) adalah vektor satuan, varians data terpusat setelah diproyeksikan ke garis yang didefinisikan oleh \(\uvec\) diberikan oleh bentuk kuadratik \(V_{\uvec} =
\uvec\cdot(C\uvec)\text{.}\)
Secara khusus, jika \(\uvec\) adalah vektor eigen satuan dari \(C\) dengan nilai eigen terkait \(\lambda\text{,}\) maka \(V_{\uvec} = \lambda\text{.}\)
Selain itu, varians bersifat aditif, seperti yang dinyatakan dalam Proposisi 7.1.16: jika \(W\) adalah subruang dengan basis ortonormal \(\uvec_1,\uvec_2,\ldots,\uvec_n\text{,}\) maka variansnya adalah
Misalkan kita bekerja dengan himpunan data yang memiliki 100 titik data berdimensi lima. Dengan demikian, matriks data terpusat \(A\) berukuran \(5\times100\) dan menghasilkan matriks kovarians \(C=\frac1{100}~AA^T\) yang berukuran \(5\times5\text{.}\) Karena \(C\) simetris, Teorema Spektral menyatakan bahwa matriks ini dapat didiagonalisasi secara ortogonal. Misalkan \(C = QDQ^T\text{,}\) dengan
Perhatikan subruang berdimensi 2 yang direntang oleh \(\uvec_1\) dan \(\uvec_2\text{.}\) Jika data diproyeksikan ke subruang ini, berapa bagian dari varians total yang dinyatakan oleh varians data hasil proyeksi?
Bagaimana jawabannya berubah jika kita memproyeksikan data ke subruang berdimensi 3 yang direntang oleh \(\uvec_1\text{,}\)\(\uvec_2\text{,}\) dan \(\uvec_3\text{?}\)
Aktivitas ini memperlihatkan bagaimana nilai-nilai eigen matriks kovarians dapat menunjukkan kapan data mengelompok di sekitar, atau bahkan seluruhnya termuat dalam, subruang berdimensi lebih rendah. Secara khusus, data semula berdimensi 5, tetapi ternyata seluruhnya berada dalam suatu subruang berdimensi 3 dari \(\real^5\text{.}\) Nanti dalam bagian ini kita akan melihat cara memanfaatkan pengamatan tersebut untuk mengolah data seolah-olah data itu berdimensi tiga, sebuah gagasan yang disebut reduksi dimensi.
Vektor-vektor eigen \(\uvec_j\) dari matriks kovarians disebut komponen utama. Kita mengurutkannya agar nilai eigen terkait tersusun menurun. Secara umum, kita berharap beberapa komponen utama pertama mempertahankan sebagian besar varians, seperti diperlihatkan oleh contoh dalam aktivitas. Dalam contoh tersebut, kita mempunyai barisan subruang
\(W_1\text{,}\) subruang berdimensi 1 yang direntang oleh \(\uvec_1\text{,}\) yang mempertahankan \(13/25 = 52\%\) dari varians total,
\(W_3\text{,}\) subruang berdimensi 3 yang direntang oleh \(\uvec_1\text{,}\)\(\uvec_2\text{,}\) dan \(\uvec_3\text{,}\) yang mempertahankan seluruh varians.
Perhatikan bahwa semakin besar dimensi subruang tempat data diproyeksikan, semakin banyak varians total yang dipertahankan. Pada akhirnya, proyeksi data ke \(W_3\) mempertahankan seluruh varians. Ini menunjukkan bahwa data harus berada dalam \(W_3\text{,}\) suatu subruang \(\real^5\) yang berdimensi lebih rendah.
Bahkan, subruang-subruang ini adalah pilihan terbaik yang mungkin. Kita mengetahui bahwa komponen utama pertama \(\uvec_1\) merupakan vektor eigen \(C\) yang berkaitan dengan nilai eigen terbesar. Artinya, varians pada arah \(\uvec_1\) adalah sebesar mungkin. Dengan kata lain, proyeksi ke garis lain mana pun akan mempertahankan varians yang lebih sedikit. Demikian pula, proyeksi ke subruang berdimensi 2 selain \(W_2\) akan mempertahankan varians lebih sedikit daripada proyeksi ke \(W_2\text{.}\) Komponen utama mempunyai kemampuan istimewa untuk memilih subruang terbaik yang mempertahankan varians sebanyak mungkin.
Tentu saja, ini merupakan contoh yang sengaja disederhanakan. Biasanya, keberadaan derau dalam suatu himpunan data membuat kita tidak berharap semua titik seluruhnya termuat dalam subruang berdimensi lebih rendah. Dalam contoh ini, subruang berdimensi 2 \(W_2\) mempertahankan \(92\%\) varians. Bergantung pada keadaan, kita dapat menganggap sisa \(8\%\) varians sebagai derau demi kemudahan bekerja dengan subruang yang dimensinya lebih rendah. Seperti yang akan kita lihat, kita mencari keseimbangan: memakai cukup banyak komponen utama untuk mempertahankan sebagian besar varians, tetapi cukup sedikit agar mudah diolah.
Di sini kita akan bekerja dengan himpunan data yang memuat 100 titik data terpusat berdimensi 3. Menjalankan sel berikut akan memplot titik-titik data tersebut dan mendefinisikan matriks data terpusat A yang berukuran \(3\times100\text{.}\)
Gunakan perintah right_eigenmatrix() untuk menentukan vektor-vektor eigen \(C\text{.}\) Ingat bahwa perintah Sage B.column(1) mengambil vektor yang dinyatakan oleh kolom kedua B. Definisikan vektor u1, u2, dan u3 yang menyatakan ketiga komponen utama menurut urutan nilai eigen yang menurun. Bagaimana Anda dapat memeriksa bahwa vektor-vektor ini merupakan basis ortonormal untuk \(\real^3\text{?}\)
Berapa bagian dari varians total yang dipertahankan dengan memproyeksikan data ke \(W_1\text{,}\) yaitu subruang yang direntang oleh \(\uvec_1\text{?}\) Berapa bagian dari varians total yang dipertahankan dengan memproyeksikan data ke \(W_2\text{,}\) yaitu subruang yang direntang oleh \(\uvec_1\) dan \(\uvec_2\text{?}\) Berapa bagian varians total yang hilang ketika data diproyeksikan ke \(W_2\text{?}\)
Alih-alih memandang data hasil proyeksi di dalam \(\real^3\text{,}\) kita akan mencatat koordinat \(\xhat\) dalam basis yang didefinisikan oleh \(\uvec_1\) dan \(\uvec_2\text{;}\) dengan kata lain, kita mencatat koordinat
Karena setiap kolom \(A\) menyatakan satu titik data, matriks \(Q^TA\) menyatakan koordinat titik-titik data hasil proyeksi. Menjalankan sel berikut akan memplot titik-titik hasil proyeksi tersebut.
Contoh ini memberikan gambaran analisis komponen utama yang lebih realistis. Plot data berdimensi 3 tampaknya menunjukkan bahwa data tersebut berada dekat suatu bidang, dan komponen utama akan mengidentifikasi bidang ini. Dimulai dari matriks data terpusat berukuran \(3\times100\text{,}\) yaitu \(A\text{,}\) kita membentuk matriks kovarians \(C=\frac{1}{100} ~AA^T\) dan mempelajari nilai-nilai eigennya. Perhatikan bahwa dua komponen utama pertama mencakup lebih dari 98% varians. Karena itu, kita dapat mengharapkan titik-titik data berada dekat \(W_2\text{,}\) yaitu subruang berdimensi dua yang direntang oleh \(\uvec_1\) dan \(\uvec_2\text{.}\)
Karena \(W_2\) merupakan subruang dari \(\real^3\text{,}\) memproyeksikan titik-titik data ke \(W_2\) menghasilkan daftar 100 titik di \(\real^3\text{.}\) Agar lebih mudah divisualisasikan, kita meninjau koordinat hasil proyeksi dalam basis yang didefinisikan oleh \(\uvec_1\) dan \(\uvec_2\text{.}\) Misalnya, kita mengetahui bahwa proyeksi suatu titik data \(\xvec\) adalah
yang merupakan vektor berdimensi tiga. Sebagai gantinya, kita dapat mencatat koordinat \(\twovec{\uvec_1\cdot\xvec}{\uvec_2\cdot\xvec}\) dan memplotnya pada bidang koordinat berdimensi dua, seperti diperlihatkan dalam Gambar 7.3.1.
Diagram berdimensi tiga dengan dua vektor ortonormal \(\uvec_1\) dan \(\uvec_2\) yang mendefinisikan suatu bidang. Pada bidang itu terdapat kisi yang menggambarkan kombinasi linear yang dibentuk oleh \(\uvec_1\) dan \(\uvec_2\text{.}\) Vektor ketiga \(\xvec\text{,}\) yang tidak berada pada bidang, ditampilkan bersama proyeksi ortogonalnya \(\xhat\text{.}\)
Diagram berdimensi dua ini menunjukkan bidang yang didefinisikan oleh basis ortonormal \(\uvec_1\) dan \(\uvec_2\text{.}\) Vektor \(\uvec_1\) mengarah mendatar ke kanan, sedangkan \(\uvec_2\) mengarah tegak ke atas. Terdapat kisi koordinat baku \(1\times1\) yang menggambarkan kombinasi linear \(\uvec_1\) dan \(\uvec_2\text{.}\) Vektor \(\xhat=\twovec{\uvec_1\cdot\xvec}{\uvec_2\cdot\xvec}\) juga ditampilkan.
Gambar7.3.1.Proyeksi \(\xhat\) dari titik data \(\xvec\) ke \(W_2\) merupakan vektor berdimensi tiga yang dapat dinyatakan dengan dua koordinat yang menggambarkan vektor tersebut sebagai kombinasi linear \(\uvec_1\) dan \(\uvec_2\text{.}\)
Dalam plot ini, koordinat pertama, yang digambarkan sebagai koordinat horizontal, menyatakan proyeksi titik data ke garis yang didefinisikan oleh \(\uvec_1\text{,}\) sedangkan koordinat kedua menyatakan proyeksi ke garis yang didefinisikan oleh \(\uvec_2\text{.}\) Karena \(\uvec_1\) adalah komponen utama pertama, varians pada arah \(\uvec_1\) lebih besar daripada varians pada arah \(\uvec_2\text{.}\) Oleh sebab itu, plot lebih menyebar pada arah horizontal daripada pada arah vertikal.
Sel berikut akan memuat himpunan data yang menggambarkan konsumsi rata-rata berbagai kelompok makanan oleh penduduk masing-masing dari empat negara konstituen Britania Raya. Satuan setiap entri adalah gram per orang per minggu.
Kita memandangnya sebagai himpunan data yang terdiri atas empat titik dalam \(\real^{17}\text{.}\) Karena itu, himpunan data tersebut tidak mungkin divisualisasikan secara langsung, dan mempelajari angka-angkanya saja tidak banyak memberi wawasan.
Selain memuat data, menjalankan sel di atas menghasilkan vektor data_mean, yaitu rata-rata keempat titik data, serta A, matriks data terpusat berukuran \(17\times4\text{.}\)
Berapakah konsumsi rata-rata kategori Minuman di keempat negara tersebut?
Tentukan matriks kovarians \(C\) beserta nilai-nilai eigennya. Karena terdapat empat titik dalam \(\real^{17}\) yang rata-ratanya nol, hanya ada tiga nilai eigen tak nol.
Tentukan komponen utama pertama \(\uvec_1\text{,}\) lalu proyeksikan keempat titik data terpusat ke garis yang didefinisikan oleh \(\uvec_1\text{.}\) Plot titik-titik tersebut pada Gambar 7.3.2
Tentukan koordinat titik-titik data terpusat yang diproyeksikan ke \(W_2\text{,}\) yaitu subruang berdimensi dua dari \(\real^{17}\) yang direntang oleh dua komponen utama pertama.
Kisi koordinat dan sepasang sumbu yang sesuai untuk memplot data hasil proyeksi. Rentang horizontal membentang dari \(-500\) hingga \(500\text{,}\) dan rentang vertikal dari \(-300\) hingga \(300\text{.}\)
Pelajari komponen utama pertama \(\uvec_1\) dan tentukan komponen pertama \(\uvec_1\text{,}\) yang bersesuaian dengan kategori pangan Minuman Beralkohol. (Untuk melakukannya, Anda dapat menggunakan N(u1, digits=2) agar hasilnya lebih mudah dibaca.) Jika suatu titik data terletak jauh di sebelah kanan plot dalam Gambar 7.3.3, apa artinya bagi konsumsi Minuman Beralkohol di negara tersebut?
Aktivitas ini menunjukkan bagaimana analisis komponen utama memungkinkan kita mengekstrak informasi dari suatu himpunan data yang mungkin sulit diperoleh dengan cara lain. Seperti pada contoh sebelumnya, kita melihat bahwa titik-titik data berada cukup dekat dengan suatu subruang berdimensi dua dari \(\real^{17}\text{.}\) Bahkan, \(W_2\text{,}\) yaitu subruang yang direntang oleh dua komponen utama pertama, mencakup lebih dari 96% varians. Yang lebih penting, ketika data diproyeksikan ke \(W_2\text{,}\) tampak jelas bahwa Irlandia Utara berbeda secara mendasar dari ketiga negara lainnya.
Dengan sedikit pemikiran tambahan, kita dapat menentukan secara lebih khusus cara Irlandia Utara berbeda. Pada plot berdimensi \(2\text{,}\) Irlandia Utara terletak jauh di sebelah kanan dibandingkan ketiga negara lainnya. Karena data telah dipusatkan, titik asal \((0,0)\) pada plot ini bersesuaian dengan rata-rata keempat negara. Koordinat titik yang menyatakan Irlandia Utara kira-kira \((477, 59)\text{,}\) yang berarti bahwa titik data hasil proyeksi berbeda dari rata-rata sebesar kira-kira \(477\uvec_1+59\uvec_2\text{.}\)
Sekarang mari kita berfokus pada kontribusi \(\uvec_1\text{.}\) Kita melihat bahwa komponen kesembilan \(\uvec_1\text{,}\) yaitu komponen yang menggambarkan Buah Segar, kira-kira \(-0.63\text{.}\) Artinya, komponen kesembilan \(477\uvec_1\) berbeda dari rata-rata sebesar kira-kira \(477(-0.63) = -300\) gram per orang per minggu. Jadi, secara kasar, penduduk Irlandia Utara memakan sekitar 300 gram Buah Segar lebih sedikit daripada rata-rata keempat negara. Hal ini didukung oleh data semula, yang menunjukkan bahwa konsumsi Buah Segar di Irlandia Utara jauh lebih rendah daripada di negara lainnya. Menelaah komponen-komponen lain dari \(\uvec_1\) memperlihatkan cara-cara lain Irlandia Utara berbeda dari ketiga negara lainnya.
Dalam aktivitas ini, kita akan menelaah himpunan data terkenal yang menggambarkan 150 bunga iris dari tiga spesies: Iris setosa, Iris versicolor, dan Iris virginica. Untuk setiap bunga, dicatat panjang dan lebar sepal serta panjang dan lebar petalnya, semuanya dalam sentimeter.
Menjalankan sel berikut akan memuat himpunan data yang terdiri atas 150 titik dalam \(\real^4\text{.}\) Selain itu, kita mempunyai vektor data_mean, yaitu vektor berdimensi empat yang memuat rata-rata titik-titik data, serta A, matriks data terpusat berukuran \(4\times150\text{.}\)
Karena data berdimensi empat, kita tidak dapat memvisualisasikannya. Tentu saja, kita dapat mengabaikan dua dari pengukuran tersebut dan memplot 150 titik berdasarkan, misalnya, panjang dan lebar sepal masing-masing bunga.
Bentuklah dua komponen utama pertama \(\uvec_1\) dan \(\uvec_2\text{,}\) beserta matriks \(Q\) yang kolom-kolomnya adalah \(\uvec_1\) dan \(\uvec_2\text{.}\)
Seperti yang telah kita lihat, kolom-kolom matriks \(Q^TA\) memuat koordinat titik-titik data terpusat setelah diproyeksikan ke \(W_2\text{,}\) yaitu subruang yang direntang oleh dua komponen utama pertama. Menjalankan sel berikut menampilkan plot koordinat-koordinat tersebut.
Misalkan kita mempunyai bunga yang koordinatnya pada bidang ini adalah \((-2.5, -0.75)\text{.}\) Bunga iris ini kemungkinan besar termasuk spesies apa? Tentukan taksiran panjang sepal, lebar sepal, panjang petal, dan lebar petal bunga tersebut.
Misalkan Anda mempunyai bunga iris, tetapi hanya mengetahui bahwa panjang sepalnya 5.65 cm dan lebar sepalnya 2.75 cm. Dengan hanya mengetahui kedua pengukuran ini, tentukan koordinat \((c_1, c_2)\) pada bidang tempat iris tersebut berada. Iris ini kemungkinan besar termasuk spesies apa? Kemudian taksir panjang dan lebar petalnya.
Misalkan Anda menemukan bunga iris lain yang lebar sepalnya 3.2 cm dan lebar petalnya 2.2 cm. Tentukan koordinat \((c_1, c_2)\) bunga iris ini dan tentukan spesies yang paling mungkin. Taksir pula panjang sepal dan panjang petalnya.
Bagian ini telah menelaah analisis komponen utama sebagai teknik untuk mengurangi dimensi suatu himpunan data. Dari matriks data terpusat \(A\text{,}\) kita membentuk matriks kovarians \(C= \frac1N ~AA^T\text{,}\) dengan \(N\) sebagai banyaknya titik data.
Vektor-vektor eigen \(\uvec_1, \uvec_2, \ldots \uvec_m\) dari \(C\) disebut komponen utama. Kita mengurutkannya agar nilai-nilai eigen yang bersesuaian tersusun menurun.
Jika \(W_n\) adalah subruang yang direntang oleh \(n\) komponen utama pertama, maka varians data terpusat yang diproyeksikan ke \(W_n\) adalah jumlah \(n\) nilai eigen pertama dari \(C\text{.}\) Tidak ada subruang berdimensi \(n\) lain yang mempertahankan lebih banyak varians ketika data diproyeksikan kepadanya.
Jika \(Q\) adalah matriks yang kolom-kolomnya merupakan \(n\) komponen utama pertama, maka kolom-kolom \(Q^TA\) memuat koordinat data, yang dinyatakan dalam basis \(\uvec_1,\ldots,\uvec_n\text{,}\) setelah data diproyeksikan ke \(W_n\text{.}\)
Tujuan kita adalah menggunakan cukup banyak komponen utama untuk mempertahankan sebagian besar varians dalam himpunan data, tetapi cukup sedikit agar tetap mudah diolah.
dan kita memiliki dua himpunan data: matriks kovarians himpunan pertama adalah \(C_1 = QD_1Q^T\text{,}\) sedangkan matriks kovarians himpunan kedua adalah \(C_2 = QD_2Q^T\text{.}\) Untuk setiap himpunan data, tentukan
Jika \(\threevec{30}{-3}{26}\) adalah salah satu titik data, tentukan koordinatnya ketika titik yang telah dipusatkan tersebut diproyeksikan ke bidang yang ditentukan oleh dua komponen utama pertama.
Tentukan apakah pernyataan-pernyataan berikut benar atau salah, dan jelaskan alasan Anda.
Jika nilai-nilai eigen matriks kovarians adalah \(\lambda_1\text{,}\)\(\lambda_2\text{,}\) dan \(\lambda_3\text{,}\) maka \(\lambda_3\) adalah varians titik-titik data terpusat ketika diproyeksikan ke komponen utama ketiga \(\uvec_3\text{.}\)
Analisis komponen utama selalu memungkinkan kita membangun representasi berdimensi lebih rendah dari suatu himpunan data tanpa kehilangan informasi apa pun.
Dalam Kegiatan 7.3.5, kita mengamati himpunan data yang terdiri atas empat pengukuran terhadap 150 bunga iris. Pengukuran tersebut adalah panjang sepal, lebar sepal, panjang petal, dan lebar petal.
Tentukan komponen utama pertama \(\uvec_1\) dan jelaskan arti keempat komponennya. Komponen manakah yang paling signifikan? Apa yang dapat Anda simpulkan tentang kepentingan relatif keempat pengukuran tersebut?
Ketika himpunan data diplot pada bidang yang ditentukan oleh \(\uvec_1\) dan \(\uvec_2\text{,}\) spesimen dari spesies iris-setosa terletak di sisi kiri plot. Apa yang ditunjukkan hal ini tentang perbedaan iris-setosa dari dua spesies lainnya dalam keempat pengukuran tersebut?
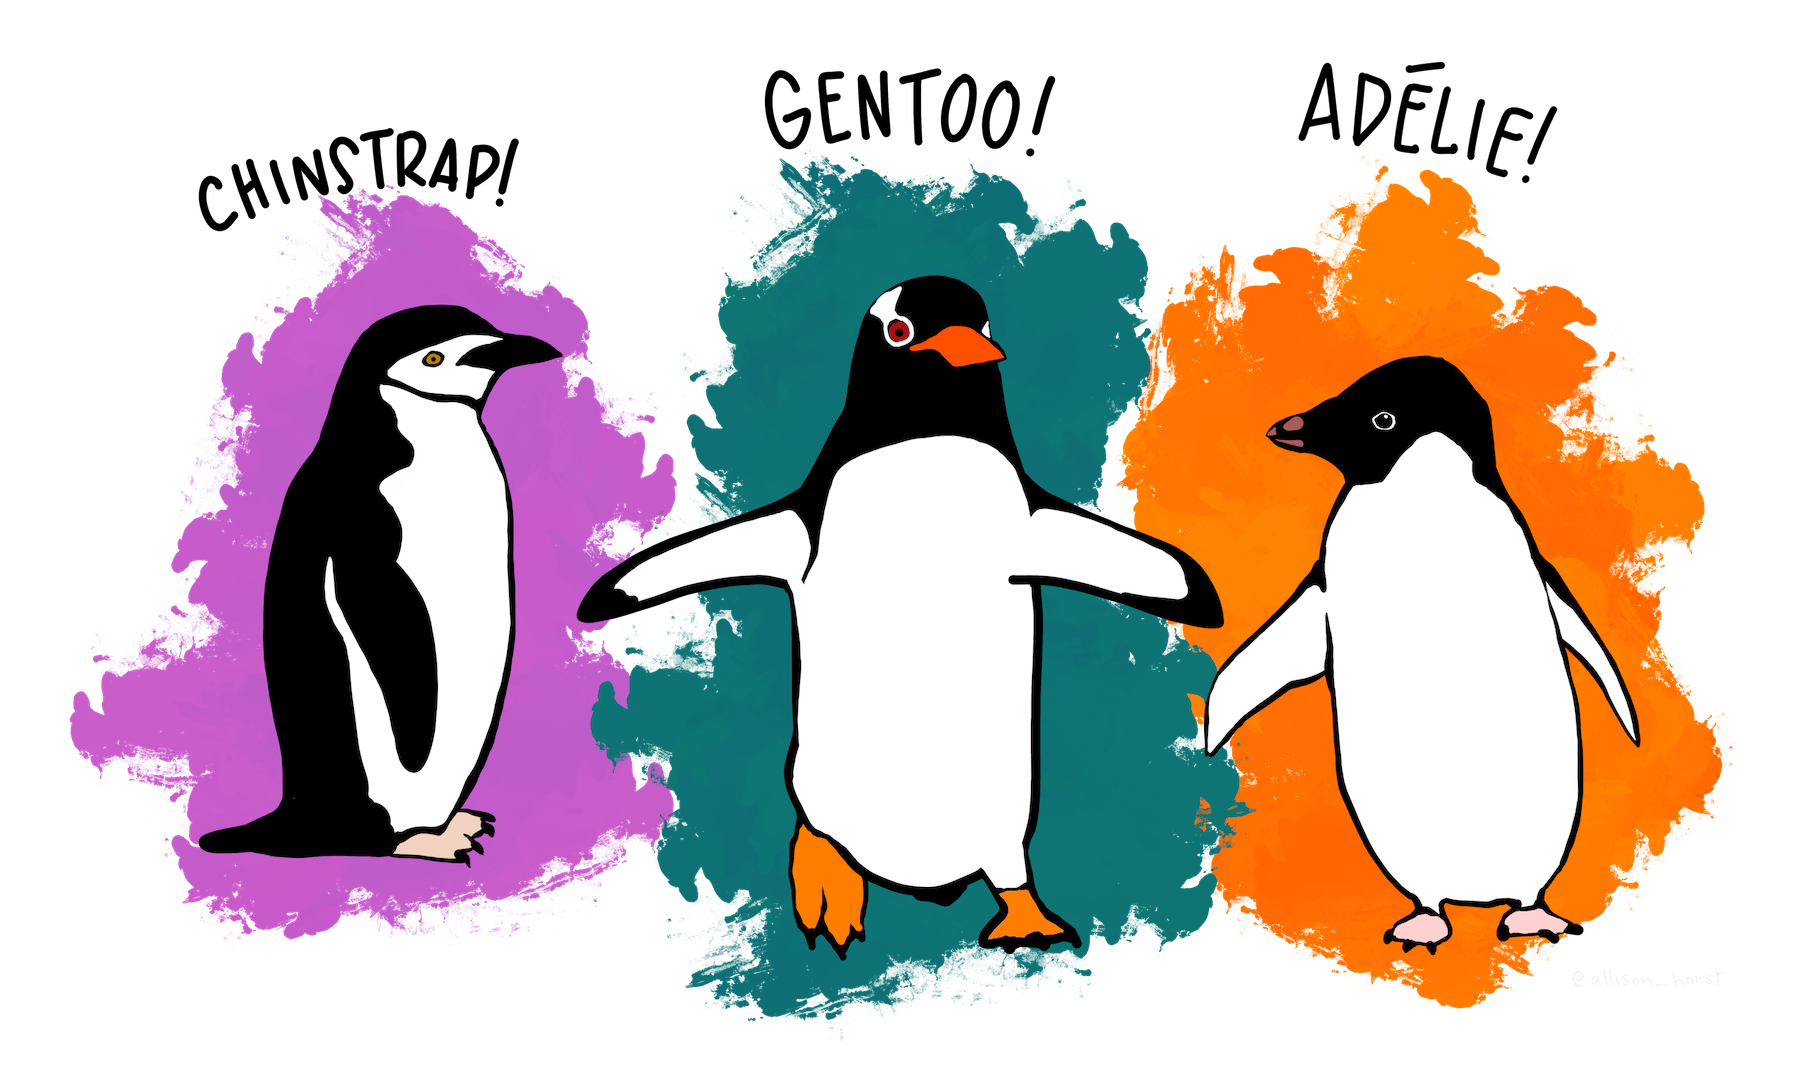
Soal ini mengeksplorasi himpunan data yang mendeskripsikan 333 penguin. Terdapat tiga spesies, Adelie, Chinstrap, dan Gentoo, seperti digambarkan di sebelah kiri Gambar 7.3.8, serta penguin jantan dan betina dalam himpunan data tersebut.
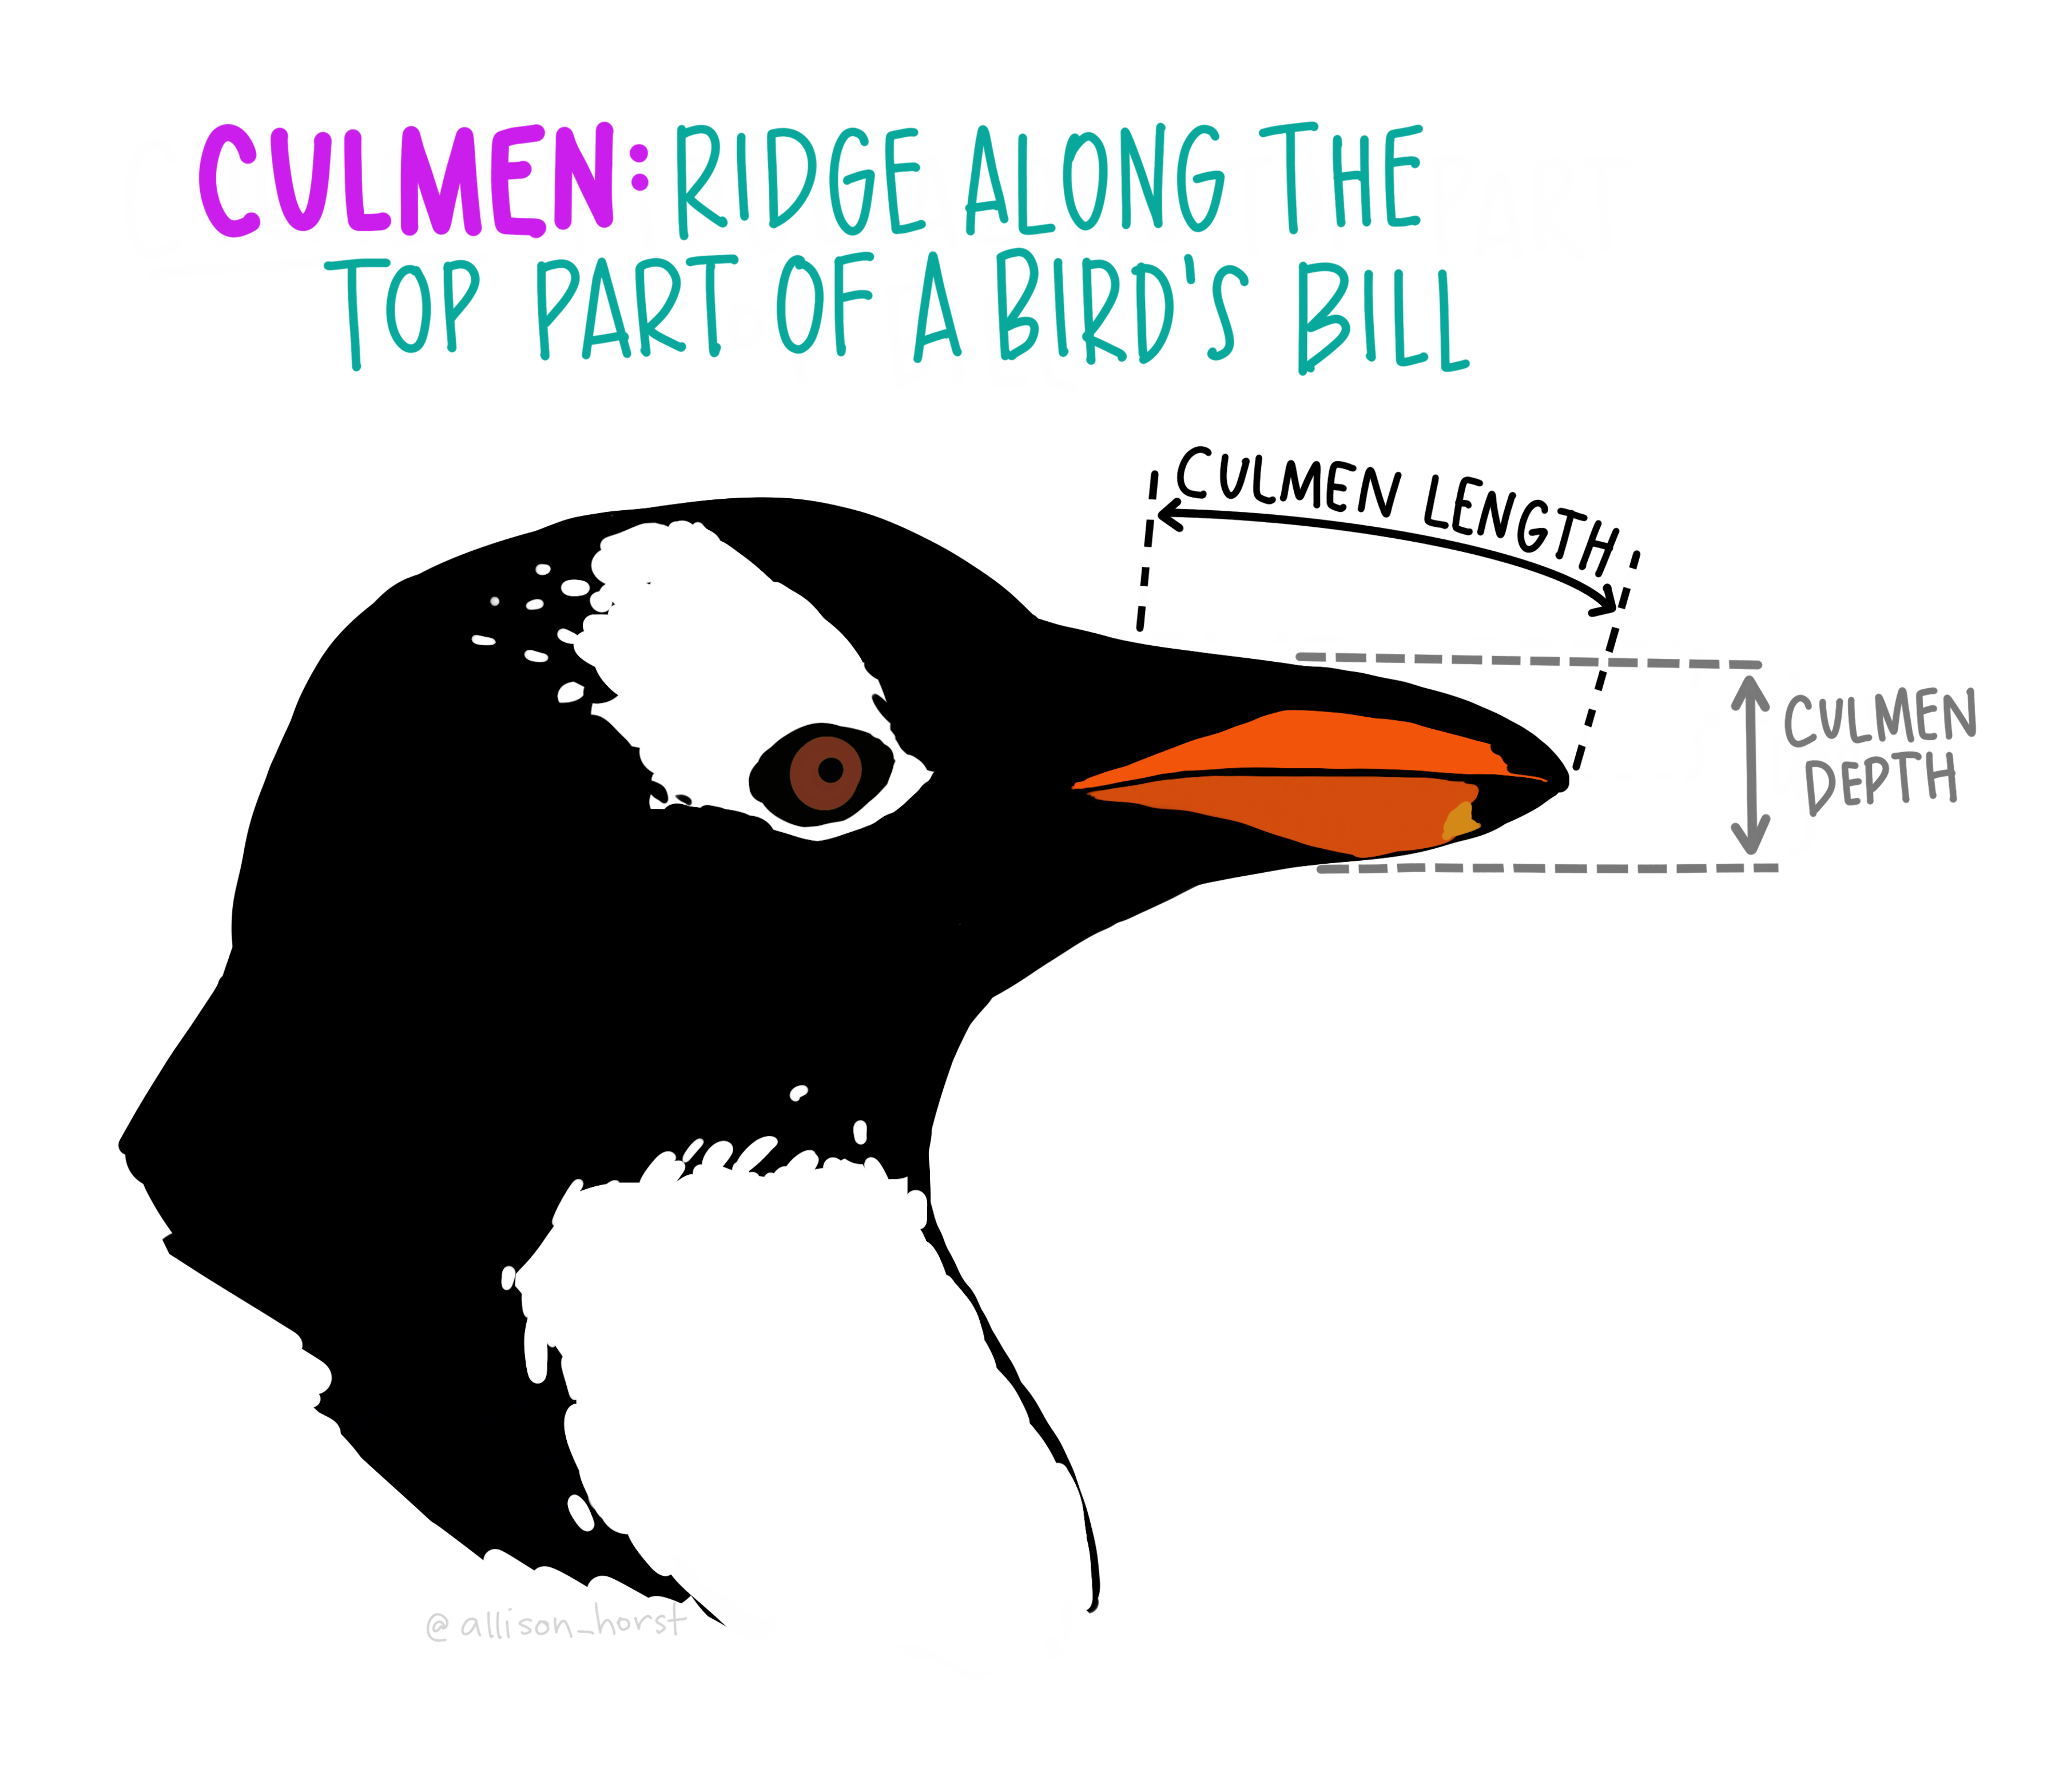
Tampak dekat kepala penguin yang menunjukkan kulmen, yaitu tonjolan memanjang di bagian atas paruh penguin. Gambar juga menunjukkan panjang kulmen, yang diukur secara horizontal, dan kedalaman kulmen, yang diukur secara vertikal.
Himpunan data ini agak berbeda dari himpunan lain yang telah kita amati karena skala pengukurannya berbeda secara signifikan. Sebagai contoh, nilai pengukuran massa tubuh kira-kira 100 kali lebih besar daripada nilai panjang kulmen. Oleh karena itu, kita akan menstandarkan data dengan terlebih dahulu memusatkannya seperti biasa, lalu menskalakan ulang setiap pengukuran dengan kebalikan simpangan bakunya. Hasilnya disimpan dalam matriks \(4\times333\) bernama A.
Bentuk matriks \(2\times333\) bernama \(B\) yang kolom-kolomnya adalah koordinat titik-titik data terpusat setelah diproyeksikan ke dua komponen utama pertama. Sel berikut akan membuat plotnya.
Periksa komponen-komponen dari dua vektor komponen utama pertama. Bagaimana massa tubuh penguin Gentoo dibandingkan dengan massa tubuh dua spesies lainnya?